Hoe AI bepaalt welke merken het aanbeveelt
Hoe bepaalt ChatGPT welke merken het noemt en aanbeveelt? Uitleg in begrijpelijke taal over taalmodellen, geheugen, live zoeken en waarom één test weinig zegt.
Heb jij bij jezelf wel eens afgevraagd hoe ChatGPT en andere AI-assistenten bepalen welke namen zij noemen in een antwoord? Je bent niet de enige. Steeds meer merken vragen zich af: hoe kan ik zien of AI mijn concurrenten aanbeveelt in plaats van mijn merk? En bovenal: wat kan ik eraan doen om vaker aanbevolen te worden? Begrip van hoe het werkt is de basis van elke goede AI Search-strategie.
In dit artikel leg ik in begrijpelijke taal uit hoe AI tot een aanbeveling komt. Je leest hoe zoeken met AI verschilt van Google, hoe een taalmodel zijn antwoord samenstelt, waarom het uitmaakt of een model uit zijn geheugen antwoordt of live zoekt en waarom één keer testen weinig zegt. In deel 2 lees je wat je eraan kunt doen om vaker aanbevolen te worden.
Noot: als ik ChatGPT noem, mag je ook Gemini, Copilot of Claude of een ander AI-platform lezen. Ze werken in de basis op dezelfde manier, ook al verschillen de uiteindelijke resultaten vaak.
Hoe we tot voor kort zochten
Google werkt met een index, een gigantische kopie van miljoenen websites. Je typt een specifieke zoekterm in en krijgt een lijst met links terug, op volgorde van relevantie. Die volgorde heet de ranking. Sta je bovenaan op de juiste term, dan klikken mensen door naar jouw site en koopt een deel van hen iets. SEO-bureau blij, jij blij en Google ook, want die verdient naast al die organische klikken miljarden aan advertentie-inkomsten op dezelfde zoektermen.
De enige die er hard voor moest werken was de consument. Die klikte meerdere hoog rankende (of bekende) aanbieders open, zocht uit welke het beste bij zijn situatie paste, checkte nog even de reviews en koos pas daarna. Dat kostte uren, maar er was geen alternatief, dus vonden we het doodnormaal.
Nu voer je een gesprek
Met de komst van ChatGPT veranderde dat. In plaats van eindeloos te zoeken, te klikken en te vergelijken, voer je gewoon een gesprek. Stel dat je een nieuwe boekhoudsoftware zoekt voor je mkb-bedrijf met twintig medewerkers. Je beschrijft je situatie, krijgt een antwoord, stelt vervolgvragen en houdt aan het eind één of twee merken over die volgens de assistent het beste bij jou passen. Grote kans dat je dan nog even de site van de aanbieder checkt of een paar reviews leest, om te bepalen of het een betrouwbare en geschikte partij is, en dan kiest.
Onthoud dat woord alvast: gesprek. Niemand, maar dan ook echt niemand, stelt slechts één losse vraag en belt meteen de bovenste naam uit het lijstje. We voeren hele conversaties met het platform voordat we een keuze maken. Wat er in het eerste antwoord gezegd wordt, is in een gesprek van belang, maar nooit het uiteindelijke doel.
Zoeken schuift dus van een lijst met links naar een conversatie met een winnaar aan het eind. Vroeger moest je hoog ranken. Nu moet je aanbevolen worden op het eind.
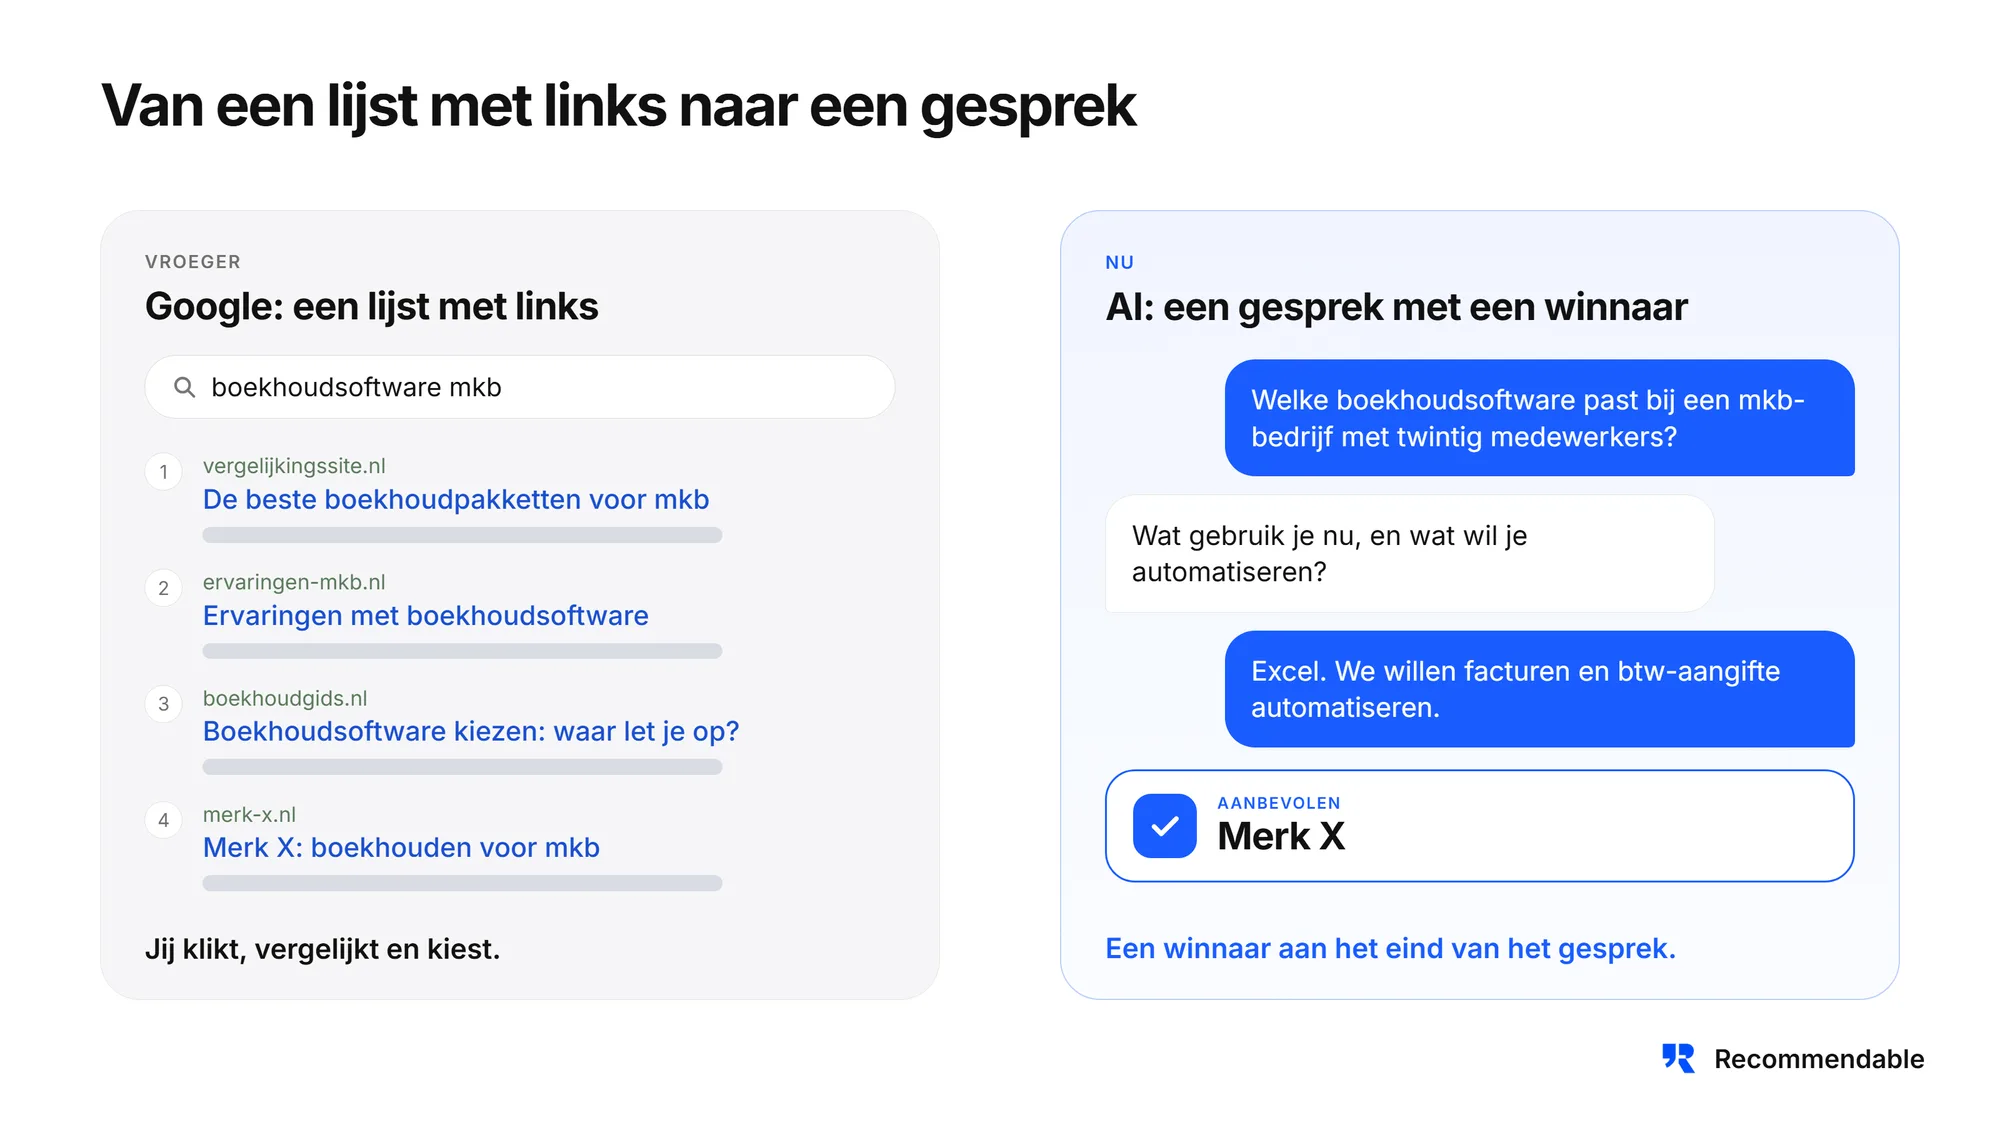
We zoeken nog steeds via Google op ‘de ouderwetse manier’. Wie anders beweert, heeft het mis of zegt het omdat dat commercieel interessanter is ;)
Google Search is en blijft een ontzettend belangrijk onderdeel van online zoektochten. Maar bij complexe aankopen, waar je moet afwegen en vergelijken, groeit het zoeken met AI hard. En over een tijdje laten we die gesprekken misschien ook helemaal voeren door AI-agents, maar dat bewaar ik voor een volgend stuk.
Hoe komt een LLM tot een antwoord?
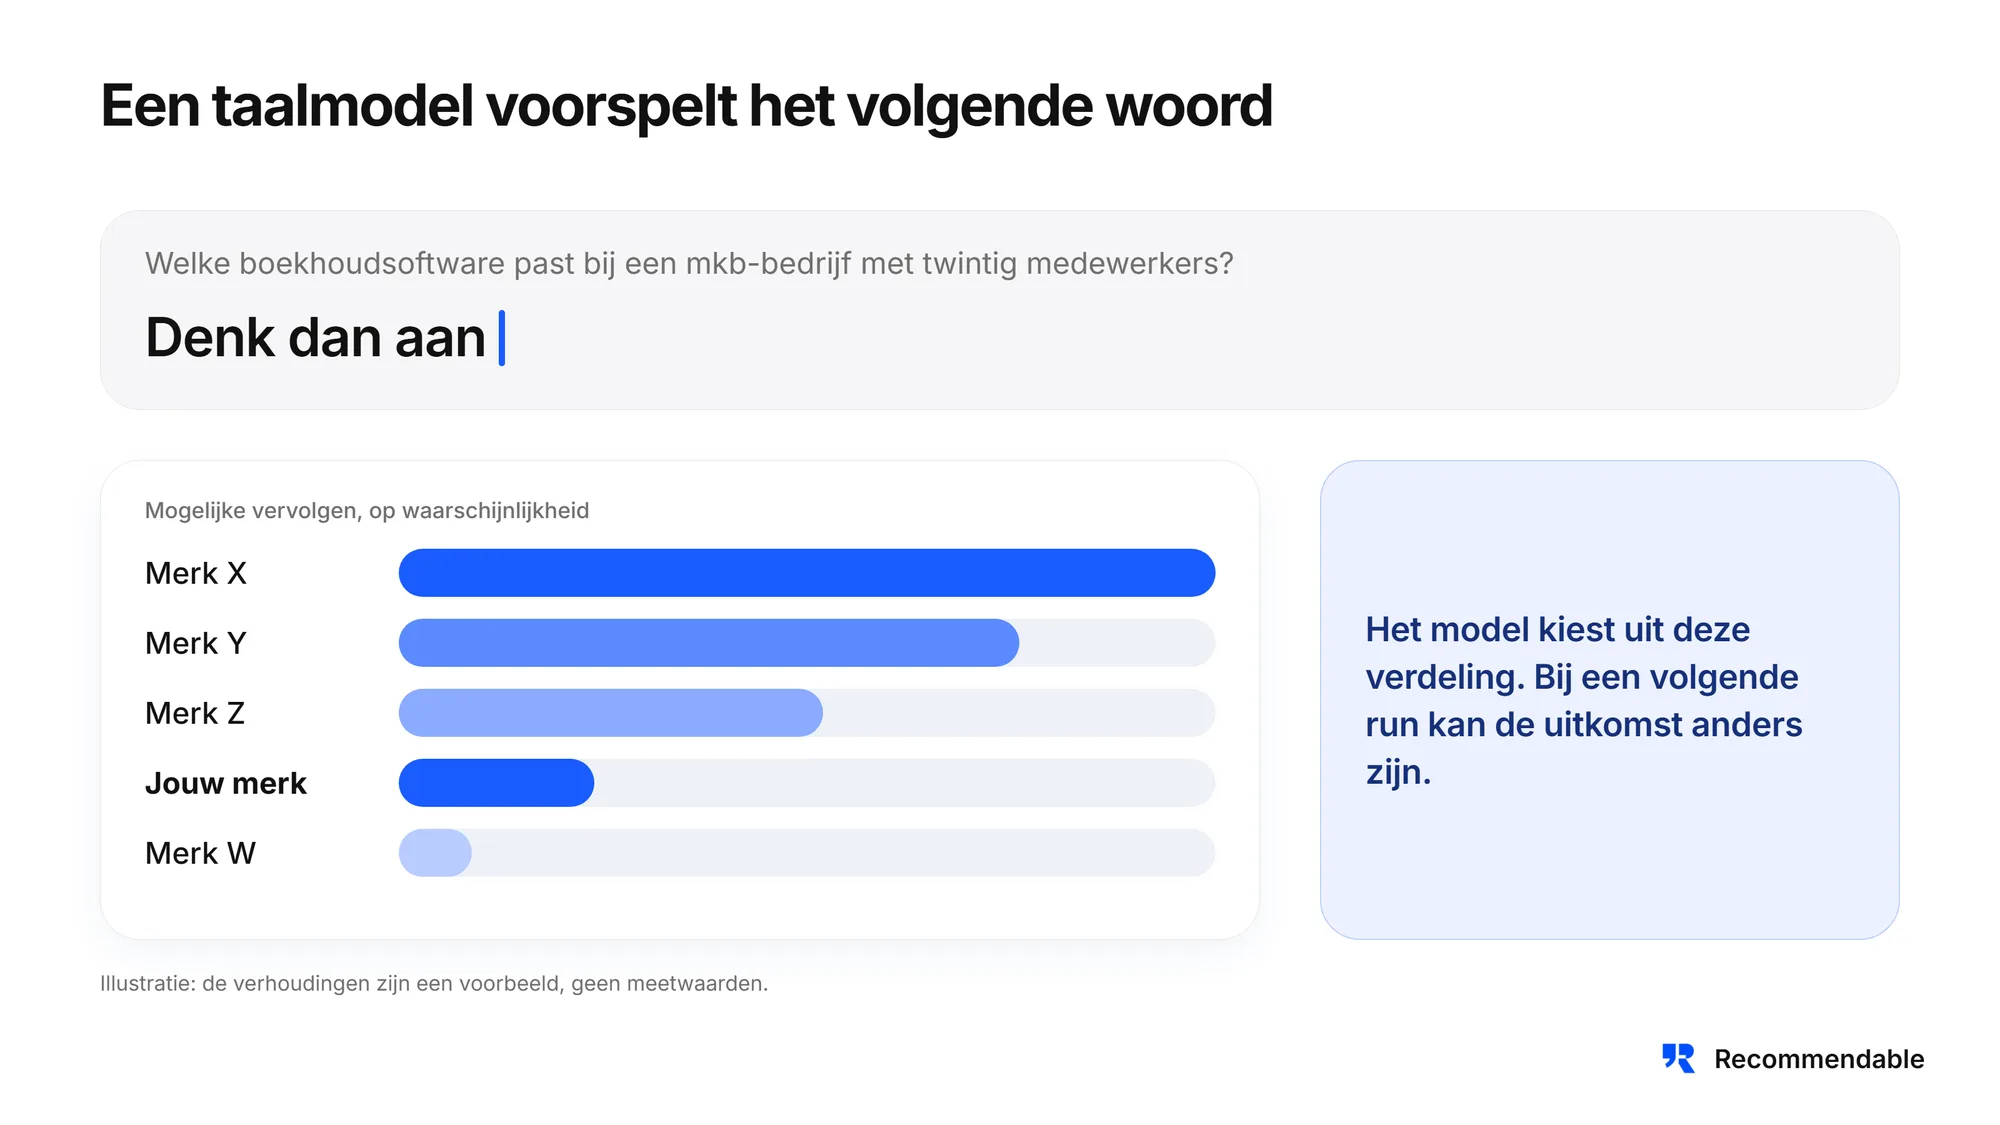
ChatGPT, Gemini en Claude zijn LLM’s: Large Language Models, oftewel grote taalmodellen. In de basis is iedere LLM een voorspelmachine. Getraind op enorme hoeveelheden tekst leerde het welke woorden, begrippen en namen bij elkaar horen. Bij elke vraag schat het op basis daarvan de meest waarschijnlijke voortzetting van de zin: het voorspelt wat het volgende woord moet worden.
Een aanbeveling is dus de meest waarschijnlijke naam in die context. Een LLM heeft geen merkvoorkeur: het herhaalt simpelweg wat het overal tegenkomt.
Stel dat je vraagt: “Welke boekhoudsoftware past bij een mkb-bedrijf met twintig medewerkers?” Dan begint het antwoord met iets als: “denk dan aan merk X en merk Y.” Dat zijn de namen die in de teksten waarop het model leerde het vaakst in de buurt van dat onderwerp stonden. Zo bouwt het model van elk merk een profiel op: waar staat het voor, bij welk onderwerp hoort het, wat zegt men ervan? Natuurlijk heeft een AI geen eigen mening of echt ‘beeld’; dit profiel bestaat onder de motorkap puur uit wiskundige gewichten en woorden die statistisch vaak samen voorkomen (co-occurrence). En daarbij heeft het geleerd van het hele internet, het beperkt zich niet tot enkel jouw site en die van je concurrenten.
AI-reputatie per merk
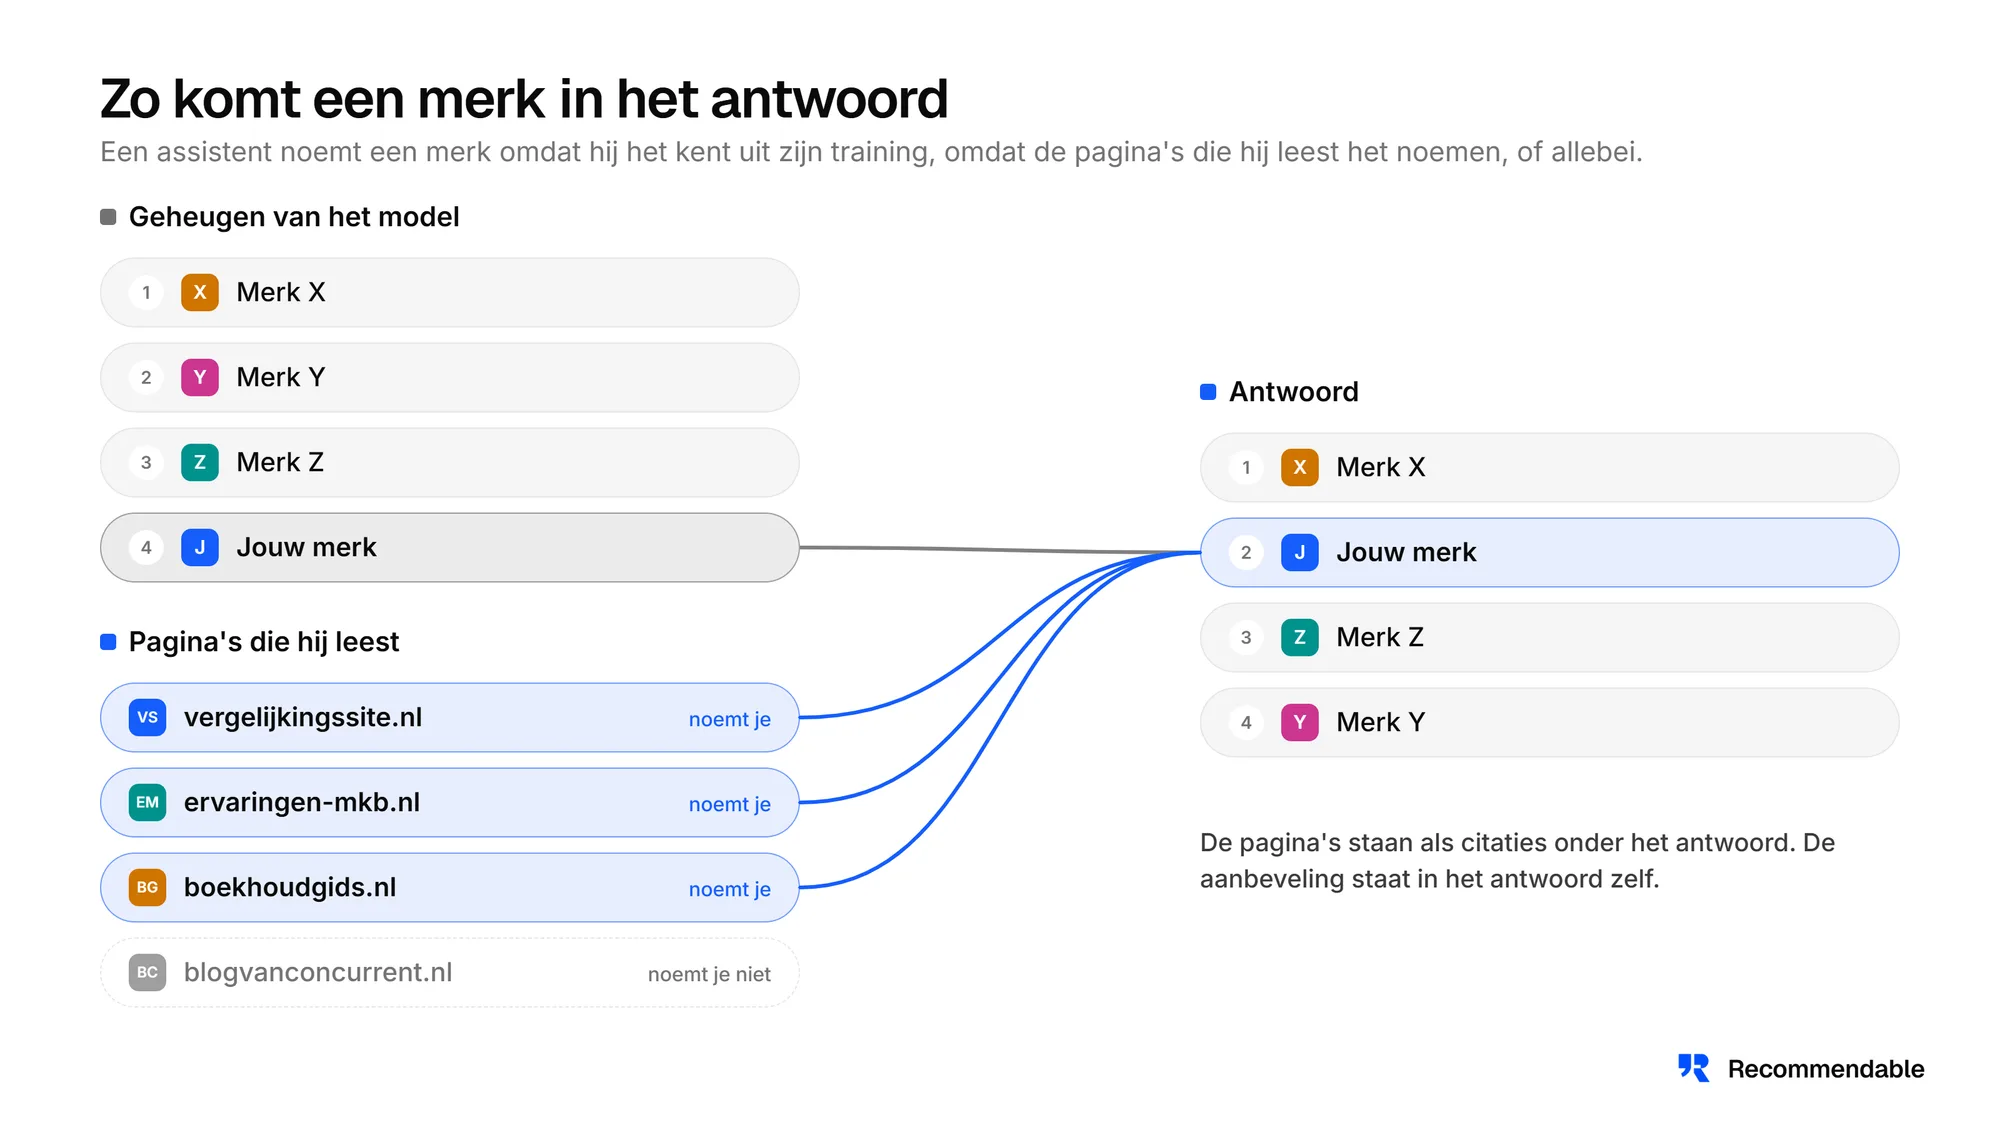
Dat beeld zit in het model zelf (en verschilt dus ook per model en platform). Je kunt het zien als de reputatie van je merk in het geheugen van het AI-platform. Welke associaties koppelt het aan jouw merk en hoe sterk zijn die associaties? Is dat beeld sterk en correct, dan komt je naam makkelijk bovendrijven in de juiste situaties. Is het vaag of verouderd, of ben je simpelweg onbekend, dan noemt het model je niet of minder vaak, of vertelt het dingen over je die niet (meer) kloppen.
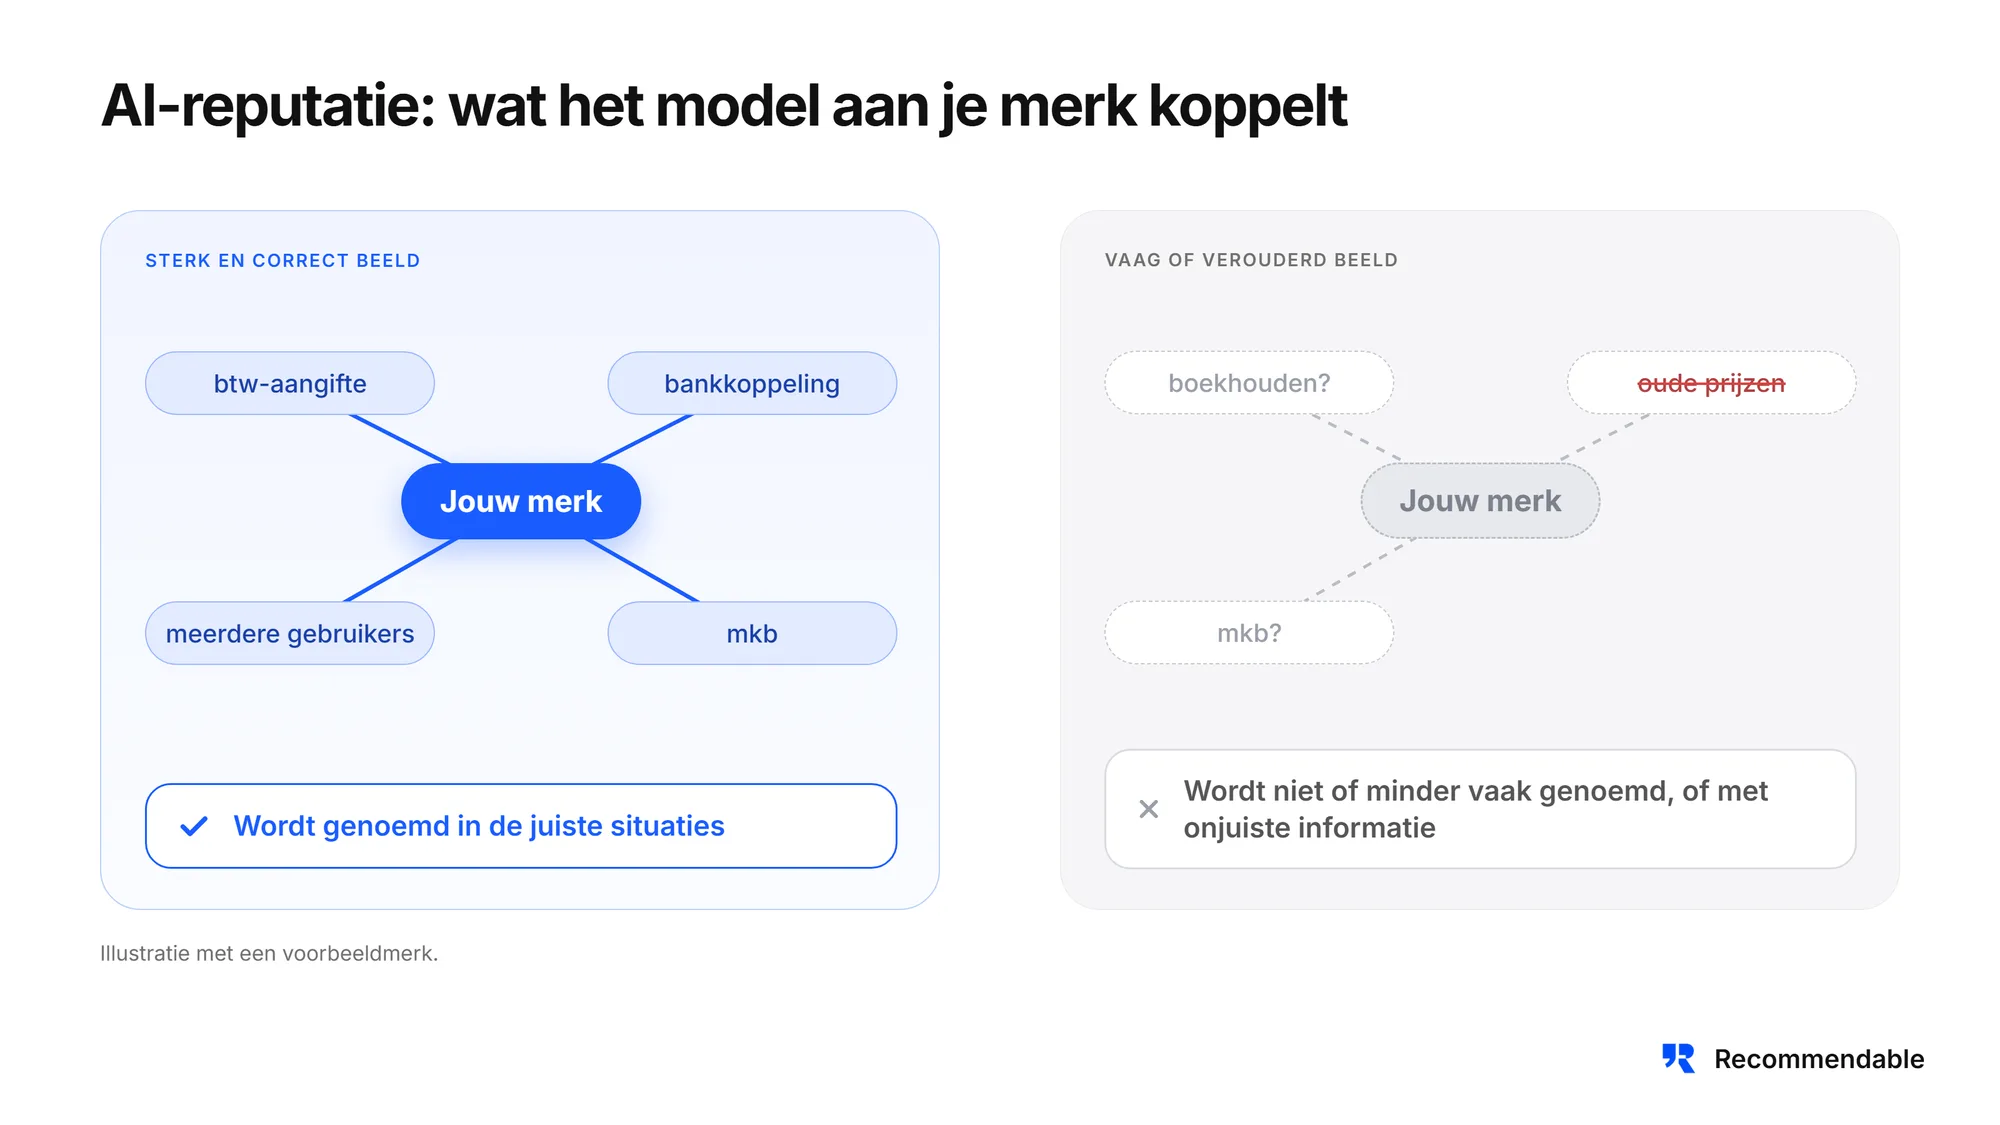
Inzicht in jouw AI-reputatie is dus goud waard.
Zo werkt AI Search anders dan het klassieke Google zoeken
Google Search en daarmee ‘klassieke SEO’ zijn in de basis deterministisch van aard. Deterministisch betekent: dezelfde invoer, dezelfde uitkomst. Natuurlijk spelen factoren als jouw locatie en zoekgeschiedenis een rol in wat je ziet, maar over het algemeen geldt: dezelfde invoer, dezelfde uitkomst. Voor een gegeven zoekopdracht geeft Google op een gegeven moment in principe een vaste set resultaten terug.
De ranking kan dus verschillen, maar is gebaseerd op vaste algoritmen, signalen en een geïndexeerde snapshot van het web. Over welke website op welke zoekterm hoog scoort, kun je dus hele zinnige dingen zeggen. Rankings veranderen als de onderliggende zaken veranderen.
AI-assistenten geven de meest waarschijnlijke antwoorden.
AI Search is probabilistisch van aard, op basis van waarschijnlijkheid dus. Taalmodellen zoals ChatGPT werken met kansen: bij elk volgend woord kiezen ze uit een verdeling van mogelijkheden. Zelfs bij dezelfde vraag kan het antwoord per run verschillen. Er is dus geen vaste ranking die wordt opgezocht. Ook nemen AI-modellen de gebruikerscontext sterk mee (wat je in het verleden al aan informatie en inzichten hebt gedeeld) en werken alle platformen en verschillende versies van modellen aan de achterkant allemaal net anders. Maar ze zijn allemaal probabilistisch van aard.
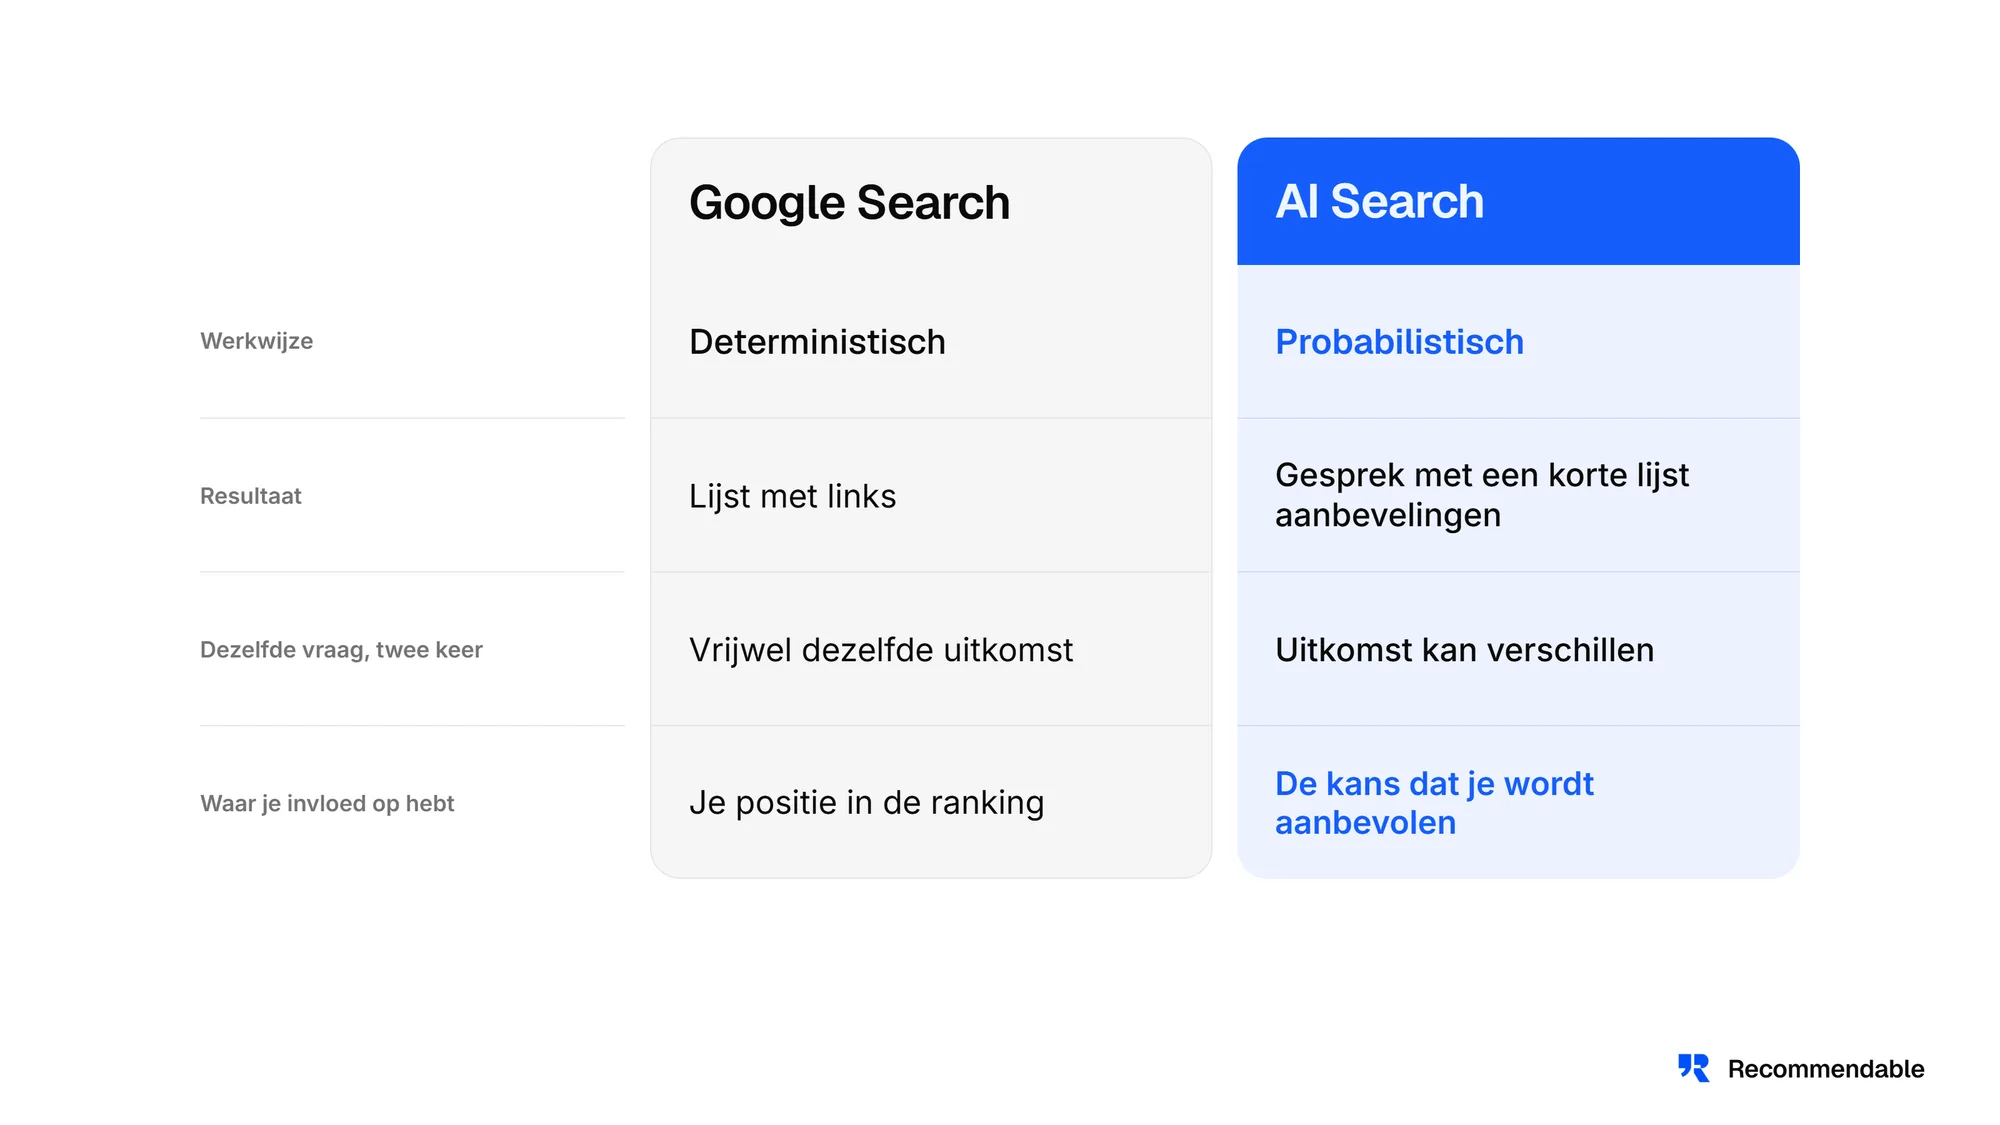
Wat je hiervan moet onthouden, is dit: in AI Search bestaat er geen vaste ranking die je ‘omhoog kunt duwen’.
Het doel van AI Search-optimalisatie is simpelweg alles wat jij doet om de kans te vergroten dat je wordt aanbevolen.
Geheugen versus live zoeken
Toen ChatGPT gelanceerd werd, had het nog geen live zoekfunctie. Alle antwoorden kwamen uit zijn geheugen: ze hebben het hele internet leeggezogen en het model heeft daarvan geleerd. Maar je kon dus ook geen actuele informatie opzoeken, simpelweg omdat de LLM niet over die informatie beschikte.
Tegenwoordig is dat anders. Nu verfijnen de modellen de eerste aanname vaak door middel van live zoeken. Eerst is er dus een antwoord uit het geheugen, en daarna kan het model het web afzoeken om dat antwoord aan te vullen of bij te stellen. Of dat live zoeken gebeurt, hangt af van de vraag, het platform en het model. Zoeken kost geld, dus daarmee heb je gelijk het antwoord op de vraag waarom ze niet altijd zoeken om het antwoord te verfijnen.
Hoe vaak ze live zoeken verschilt per type vraag en model, maar uit onze eigen data van Recommendable blijkt dat ChatGPT, Gemini en Claude over het algemeen rond de 85 tot 95% van de prompts zoekt. Perplexity zoekt altijd, die heeft namelijk geen geheugenmodus.
Query fan-out
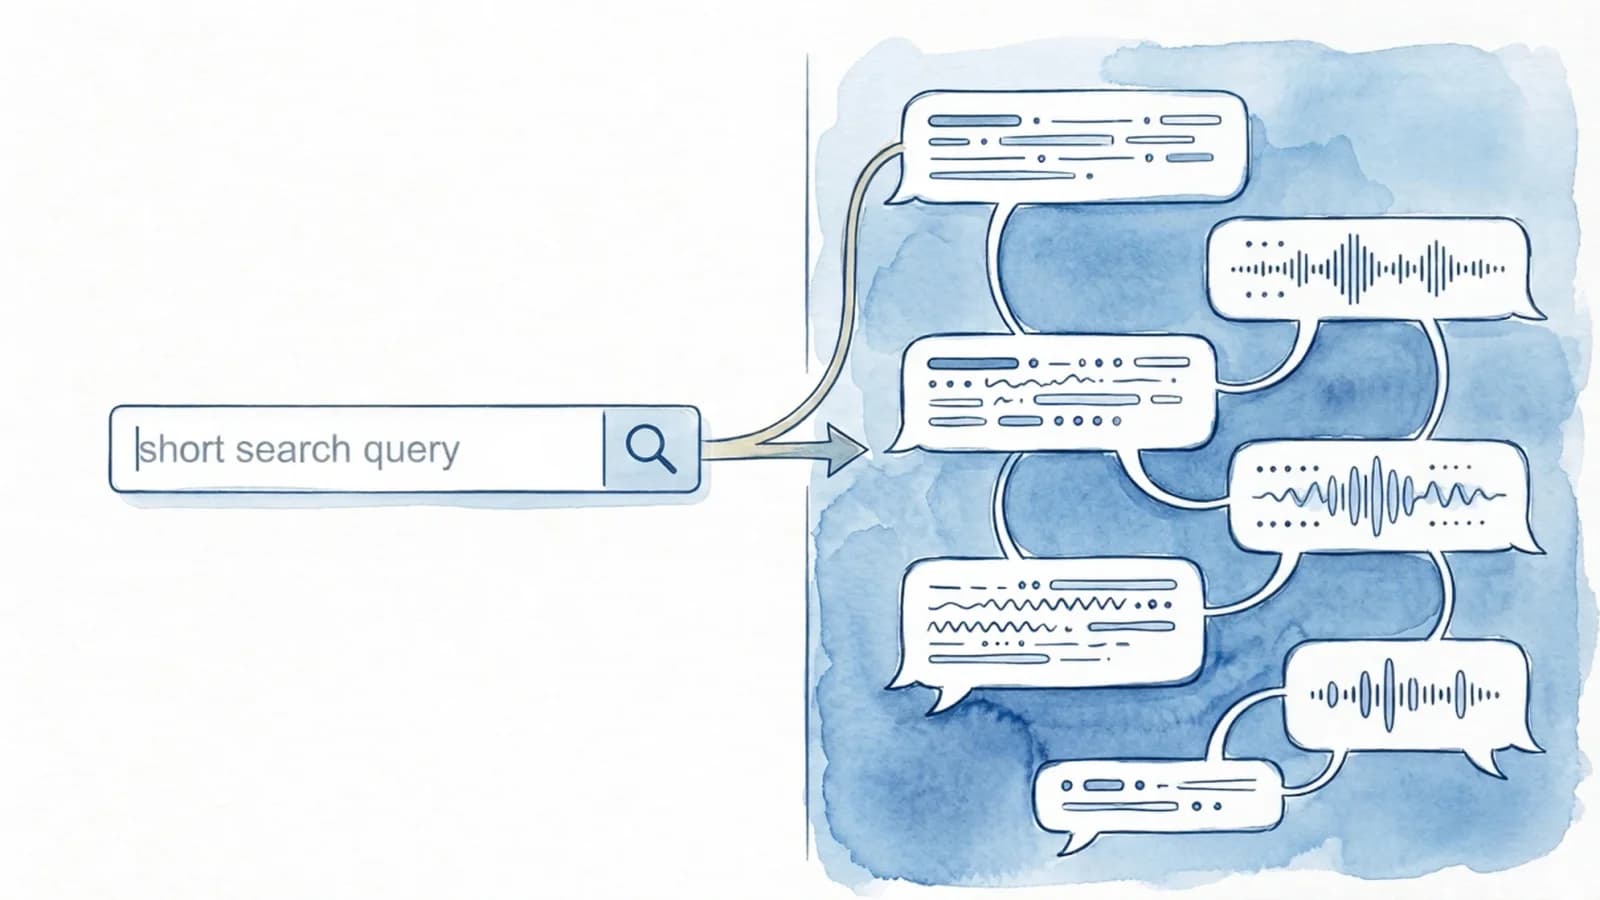
Bij live zoeken gebeurt er iets dat query fan-out wordt genoemd. Hierbij ontleedt de LLM jouw hoofdvraag, knipt deze op in meerdere heel specifieke deelvragen en zoekt op die manier naar informatie, vat die razendsnel samen en geeft antwoord.
Een voorbeeld ter illustratie: op de hoofdvraag “Welke boekhoudsoftware past bij een mkb-bedrijf met twintig medewerkers?” kan het model deelvragen laten uitgaan, zoals “boekhoudsoftware mkb prijzen vergelijken” en “ervaringen met boekhoudpakketten voor mkb”.
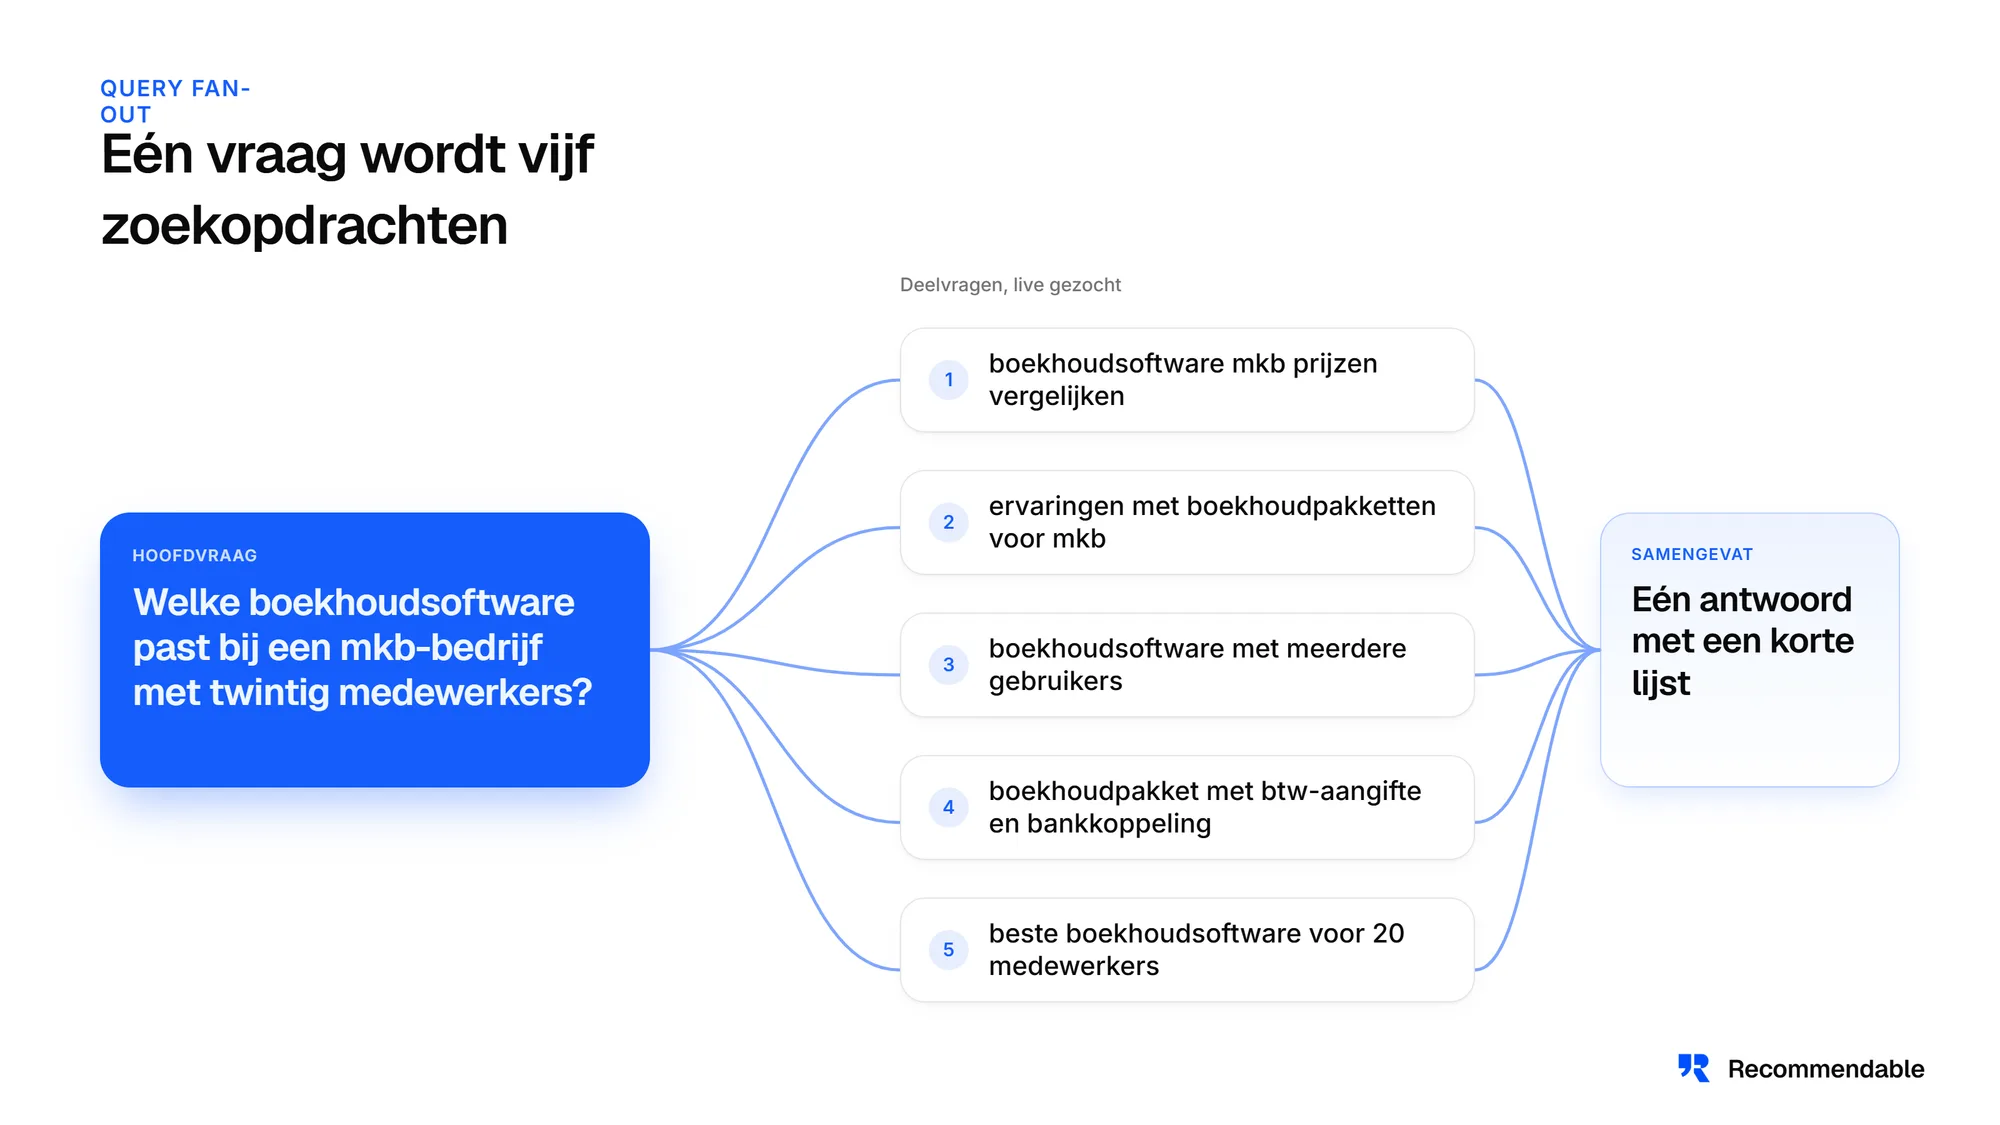
De manier waarop ze die deelvragen opknippen kan ook nog weleens veranderen. Normale gebruikers zien die deelvragen niet, maar er zijn methodes, zoals plugins en tools, om ze toch inzichtelijk te maken (Recommendable doet dat ook).
Het verschilt tussen citaties, vermeldingen en aanbevelingen
Bij live zoeken heb je naast die deelvragen ook citaties: de bronnen die onder een antwoord staan. Antwoordt het model uit zijn geheugen, dan staan die er niet. Veel marketeers zien het gegeven dat jouw site vaak wordt geciteerd als een van de belangrijkste metrics voor AI-zichtbaarheid, en veel tools rapporteren het ook zo, maar dat is ten onrechte. Mijn ervaring is dat vrijwel niemand op die bronnen klikt. Je hebt je antwoord al en de bronnen staan ergens onderaan of achter een icoontje. Een citatie is niets anders dan een bronvermelding.
Wat je hiervan kunt onthouden: een citatie is slechts een middel. Een GEO-tool of aanbieder die roept dat ze je vaker geciteerd laten worden, of daar hun hele strategie omheen bouwen, optimaliseert voor het verkeerde doel.
Daarnaast heb je vermeldingen: dat geeft aan dat jouw merk in het eerste antwoord wordt genoemd. Maar waar het om draait, zijn aanbevelingen: word je aan het eind van de conversaties actief aanbevolen als de beste optie voor de gebruiker?
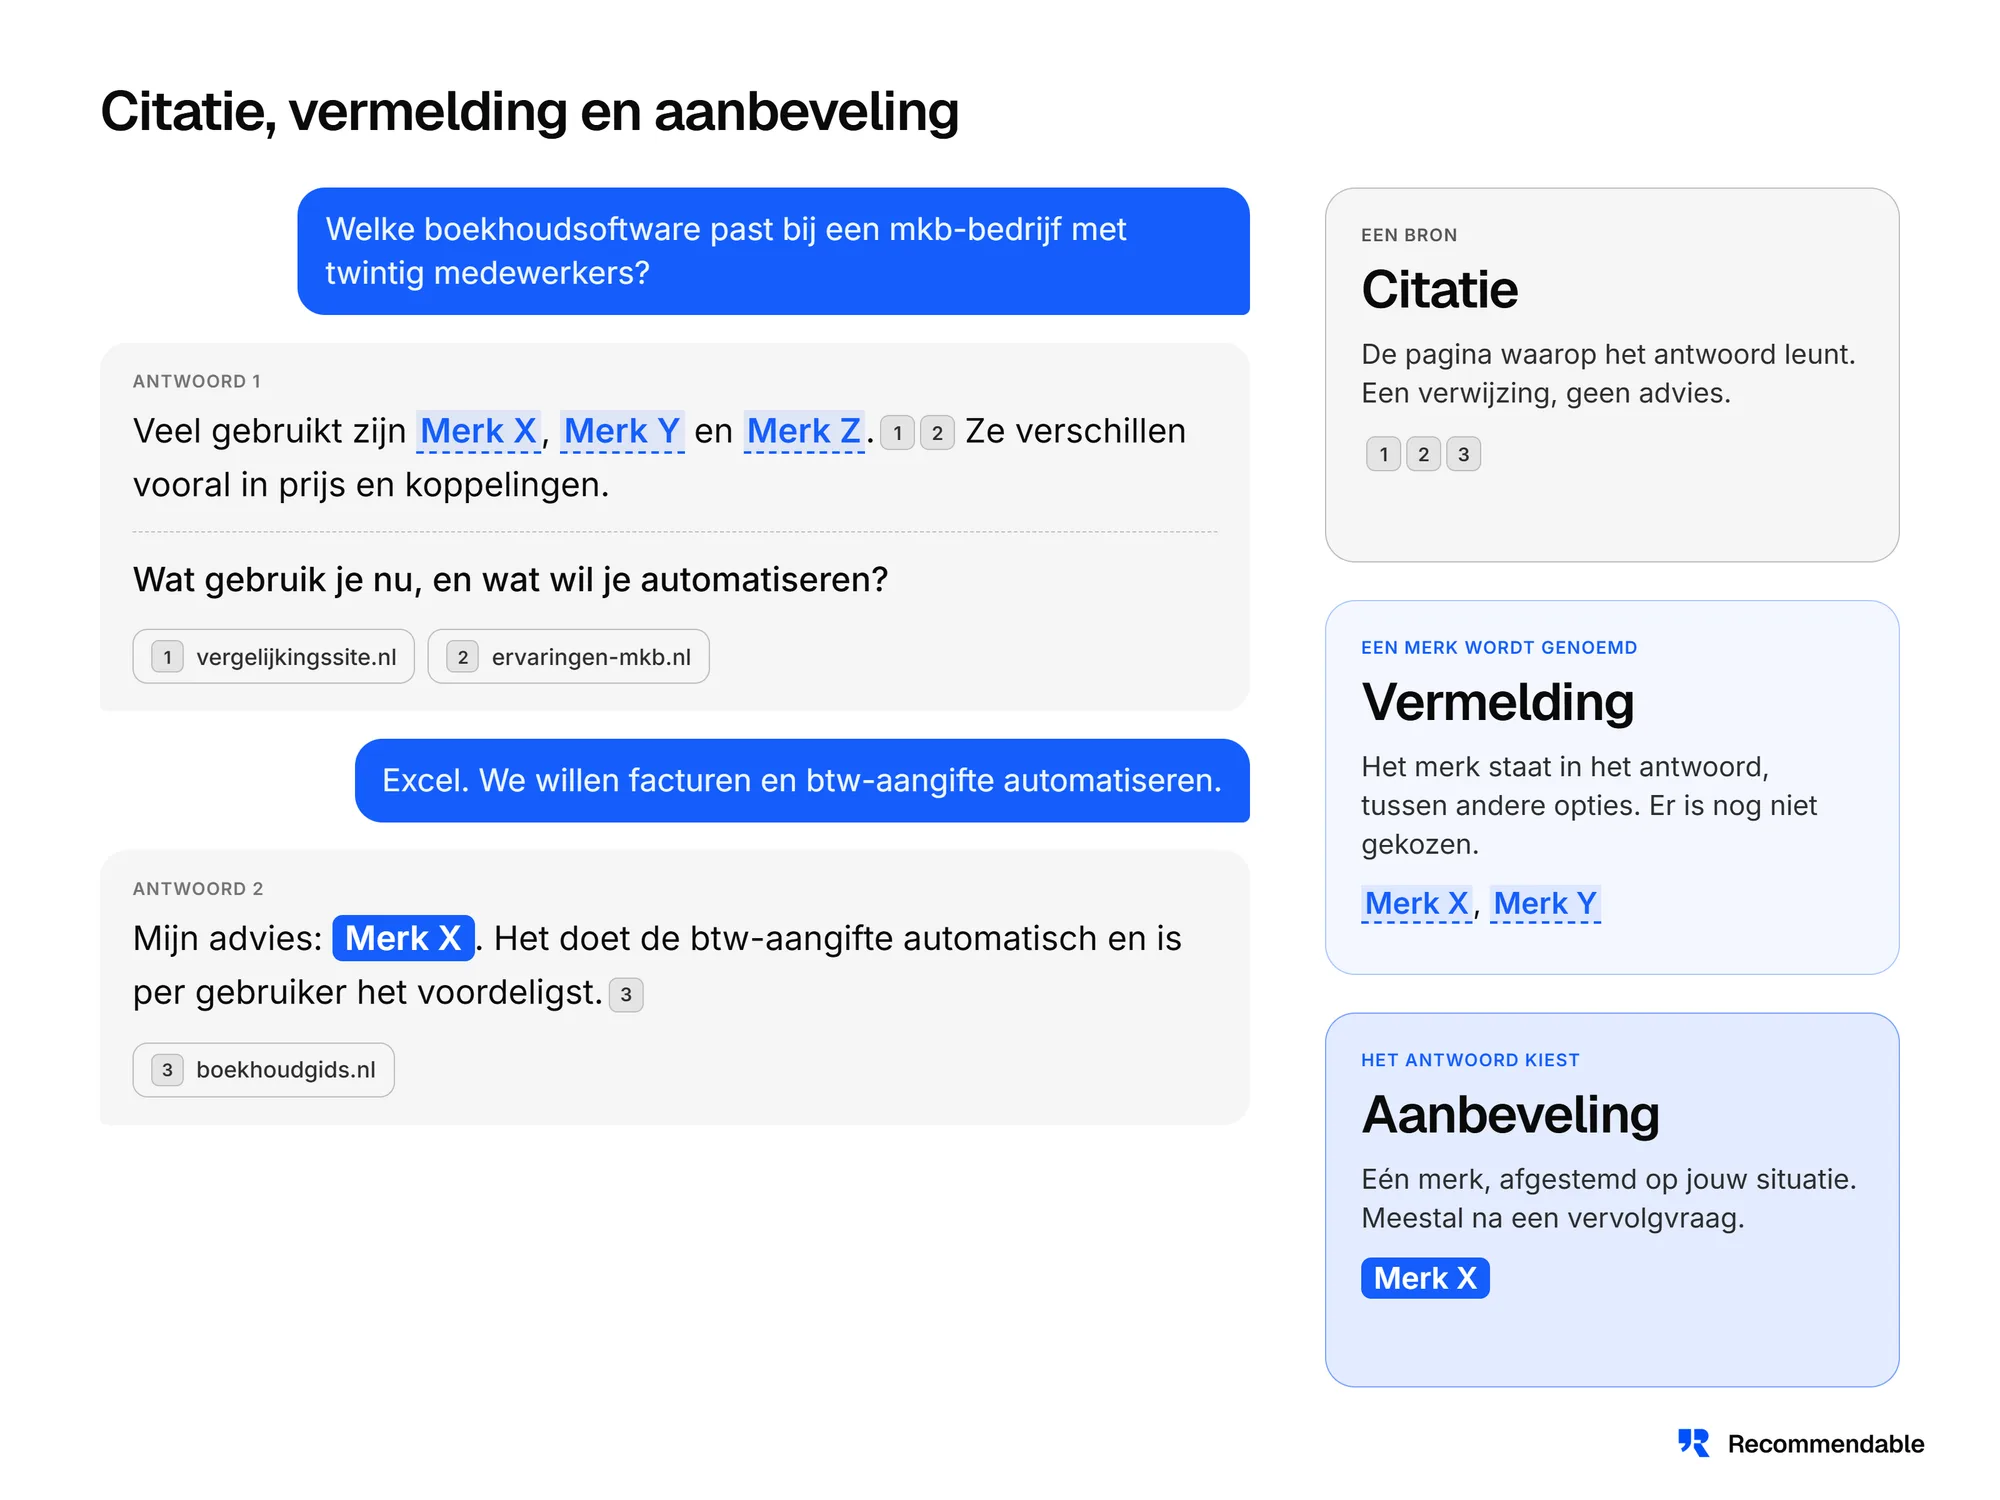
Een aanbeveling staat in het laatste antwoord zelf en dat is wat je wil bereiken. Aanbevelingen komen allereerst voort uit het geheugen en daarna uit de resultaten van de live zoekopdrachten. Die resultaten kunnen het antwoord dus wel degelijk beïnvloeden, maar de citatie is alleen het zichtbare spoor ervan. Dat je geciteerd wordt, betekent niet dat je ook wordt aanbevolen.
Waarom één keer kijken of je genoemd wordt weinig zegt
Hoe kun je nou zien of AI jouw concurrenten aanbeveelt in plaats van jou? Veel andere artikelen komen dan met het volgende advies: test het zelf door gerichte koopvragen te stellen aan ChatGPT, wellicht in incognitomodus. Maar wat ze daarbij vergeten, is dat AI probabilistisch is, waar we het eerder al over hadden. Dat je een keer wel of niet genoemd wordt, zegt op zich nog niet zoveel en geeft geen goed beeld van jouw prestaties.
Hieruit komt ook een van mijn grootste kritiekpunten op veel GEO-tools. Het zijn ‘prompt trackers’: tools die met een vaste regelmaat een zelfgekozen collectie prompts op de verschillende modellen afvuren, turven hoe vaak jouw merk in het eerste antwoord wordt vermeld of jouw site wordt geciteerd, en dat in een gelikt dashboard gieten. Het ziet er vaak mooi uit en als ze dagelijks meten laten ze mooie trendlijntjes zien in fancy kleurtjes. Op het eerste oog indrukwekkend. Maar schijn bedriegt. Of hun resultaten statistisch betrouwbaar genoeg zijn om onderbouwde uitspraken te doen, vermelden of meten ze vaak niet.
Het zijn deterministische tools gebouwd voor een probabilistisch platform.
Dit is op te lossen. Je meet vaker en houdt rekening met de variatie in antwoorden, zodat je statistisch betrouwbare uitspraken kunt doen met een betrouwbaarheidsinterval. Ouderwetse statistiek in optima forma. Het nadeel is dat het meten duurder uitvalt, want je haalt veel vaker resultaten op. Maar wat heb je liever: goedkopere maar onbetrouwbare metingen, of iets duurdere maar betrouwbare? Ik kies voor het laatste.
Genoemd worden is leuk, maar zegt niet of je ook wordt aanbevolen
Maar ook als je het altijd correct meet, moet je goed beseffen wat je meet. Enkel genoemd worden in het eerste antwoord is heel wat anders dan aanbevolen worden aan het eind van een heel gesprek. Mensen voeren hele gesprekken met ChatGPT voordat ze een keuze maken.
Genoemd worden of citeerbaar zijn is leuk, maar vaker aanbevolen worden is waar het in AI Search echt om draait.
De vragen die hieruit volgen
We zijn begonnen met begrip op hoofdlijnen hoe AI Search werkt, maar dan krijg je vanzelf nieuwe vragen, zoals:
Als AI steeds andere antwoorden geeft, hoe kan ik dan statistisch betrouwbare uitspraken doen over mijn zichtbaarheid?
Hoe scoor ik in het geheugen versus bij live zoeken, en kan ik daar inzichten uithalen die mijn strategie verbeteren?
Wat is de reputatie van mijn merk op de verschillende platformen, en zitten daar grote verschillen tussen?
Klopt alles wat ze denken, en wat moet ik doen zodat AI het juiste beeld van mij heeft in zijn geheugen?
Hoe zie ik of AI mijn concurrenten aanbeveelt in plaats van mij, en bij welke vragen?
Hoe zorg ik ervoor dat ik niet alleen genoemd word in het eerste antwoord, maar ook aanbevolen word in het laatste antwoord? En is dat te meten? Zo ja, hoe?
Kortom, na begrip volgt verdieping. Die verdieping ga ik de komende tijd hier vaker geven. In deel 2 laat ik zien wat je op hoofdlijnen kunt doen om vaker aanbevolen te worden.
Op deze vragen geeft Recommendable antwoord, en daar bouw ik het ook op. Het platform onderzoekt hoe AI-assistenten over je merk praten en of ze je aanbevelen, op basis van volledige gesprekken, op meerdere platformen en met herhaalde metingen, zodat je een betrouwbaar beeld krijgt in plaats van een toevallige uitkomst.
Peter werkt sinds 2008 in search en digitale strategie. Bij Recommendable onderzoekt hij hoe AI het zoeklandschap en het marketingvak fundamenteel verandert.